Meet Qwen. Onze nieuwe collega draait lokaal
22 oktober 2026 - Alexander D'hoore
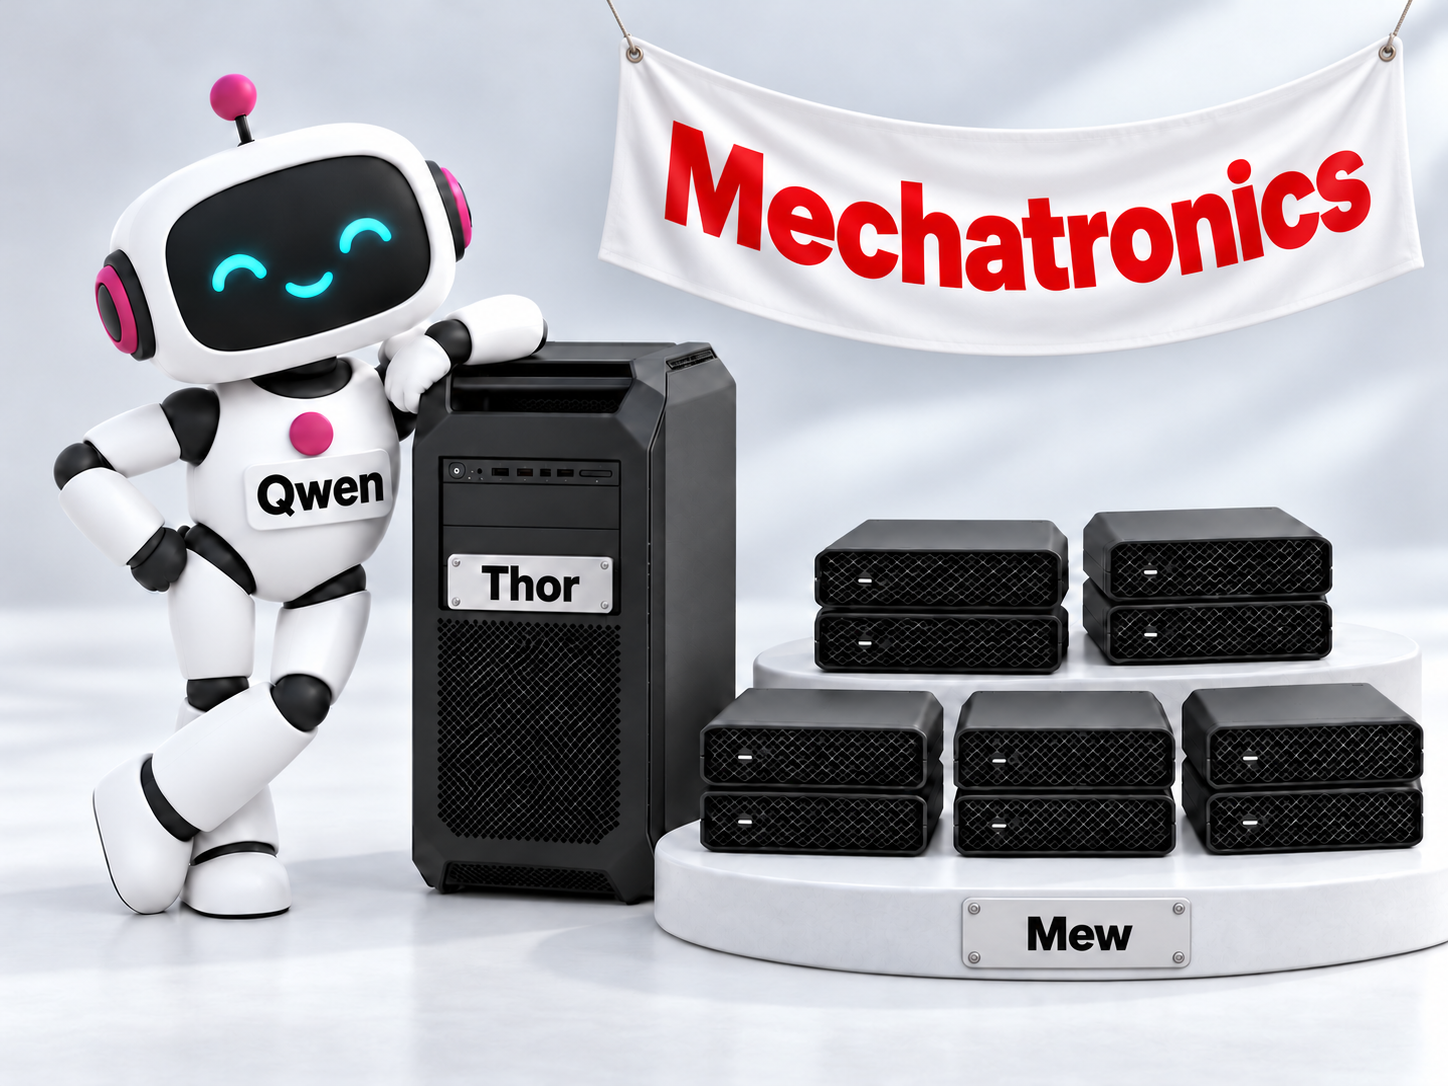
Bij de onderzoeksgroep Mechatronics van VIVES hebben we een nieuwe onderzoekscollega. Deze collega heeft 27 miljard parameters en woont in de serverruimte in Brugge. Haar naam: Qwen!
Qwen helpt de onderzoekers bij softwareontwikkeling, data science, serverbeheer en het uitwerken van talloze onderzoeksprojecten. Ook studenten krijgen hulp bij het schrijven van software en het inbouwen van intelligentie in hun applicaties.
Een eigen bureau heeft deze collega niet nodig. Een behoorlijke verzameling GPU's wel. Voor Qwen hebben we een lokale LLM-cluster gebouwd op onze gedeelde serverinfrastructuur. We spreken Qwen aan vanuit onze development tools of via een API. Voor ons is Qwen één AI-collega. Achter de schermen werken een krachtige Blackwell-GPU en tien kleinere Ada-GPU's samen.
Waarom we dat doen, hoe de servers samenwerken en wat jouw bedrijf ermee zou kunnen? Tijd voor een kijkje achter de schermen.
Een collega die niet halverwege op de abonnementslimiet botst
Je kent het misschien. Je zit midden in een ontwikkeltaak, de AI-assistent kent je code en de oplossing begint vorm te krijgen. Dan verschijnt de melding dat je gebruikslimiet bereikt is.
Alle onderzoekscollega's bij VIVES hebben toegang tot een ChatGPT- of Claude-abonnement. Hoeveel werk we daarmee kunnen verzetten, is alleen niet altijd even voorspelbaar. Daarom schuift Qwen mee aan als betrouwbare collega voor het dagelijkse ontwikkelwerk.
Qwen werkt vanuit onze eigen serverruimte en staat dag en nacht klaar om ons te helpen. Zo kunnen onderzoekers en studenten blijven werken, ook wanneer de limiet van een extern abonnement bereikt is. Per taak kiezen we wat het best past: onze lokale Qwen of een van de modellen in ChatGPT of Claude.
Welkom in de machinekamer
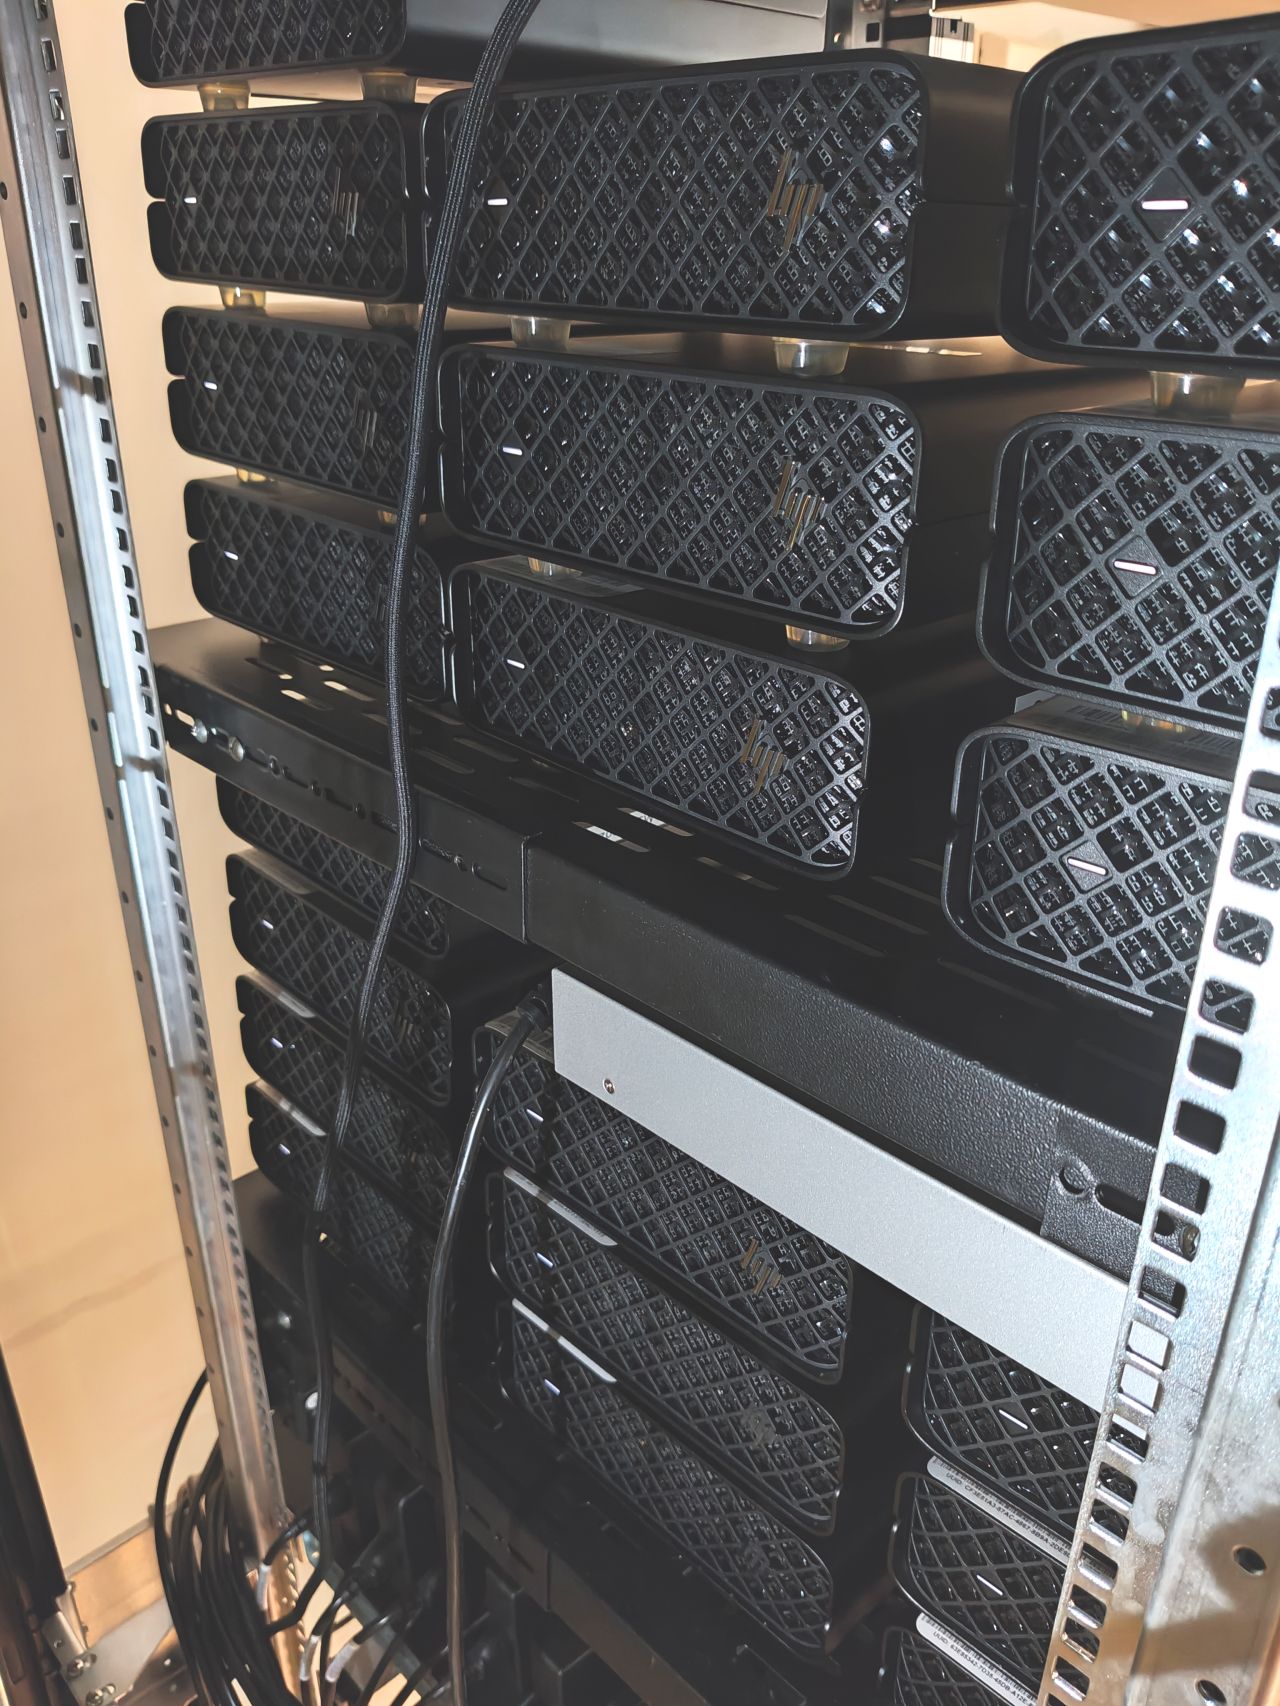
Deze infrastructuur was er niet van de ene dag op de andere. Onderzoeksgroep Mechatronics heeft door de jaren heen een gemeenschappelijke serveromgeving uitgebouwd, met hardware uit verschillende onderzoeksprojecten en investeringen.
Hier draaien applicaties, worden data verwerkt en experimenteren collega's met AI. Sommige GPU-servers worden gebruikt om modellen te trainen, andere om ze uit te voeren. De LLM-cluster is een nieuwe toepassing op die gedeelde basis.
Eén antwoord, een heel team GPU's
Op de cluster draait Qwen3.8-27B, in de compacte NVFP4-versie van NVIDIA. Het werk verdelen we over elf GPU's: één krachtige RTX PRO 6000 Blackwell met 96 GB VRAM in Thor en tien kleinere RTX 4000 SFF Ada-GPU's met elk 20 GB in de Mew-cluster. Die laatste werken samen in vijf paren.
Waarom die combinatie? Een antwoord maken bestaat uit twee verschillende taken. Eerst moet Qwen de vraag en alle meegestuurde informatie lezen: eerdere berichten, documenten of code. Dat heet prefill. Bij veel nieuwe informatie vraagt dat flink wat rekenwerk. Daarom neemt de krachtige GPU in Thor dit voor zijn rekening.
Daarna schrijft Qwen het antwoord stukje voor stukje uit. Dat heet decode. Dit werk gebeurt op de kleinere GPU-paren. SGLang regelt die taakverdeling en de overdracht van de verwerkte context over het netwerk. Zo kan Thor zich al met een volgende vraag bezighouden terwijl een Mew-paar een antwoord uitschrijft.
Voor de gebruiker werkt de cluster als één AI-dienst: we stellen Qwen een vraag en krijgen een antwoord terug. LiteLLM ontvangt de requests en de SGLang-router regelt welke servers het werk uitvoeren. Die samenwerking gebeurt automatisch. Wie zelf onder de motorkap wil kijken, vindt meer in het SGLang-cookbook.
De Mew-cluster werd aangekocht binnen het VLAIO OI.HS-onderzoeksinfrastructuurproject Versatile Edge Cluster. Meer over die hardwarebasis lees je op de Edge Clusters-pagina.
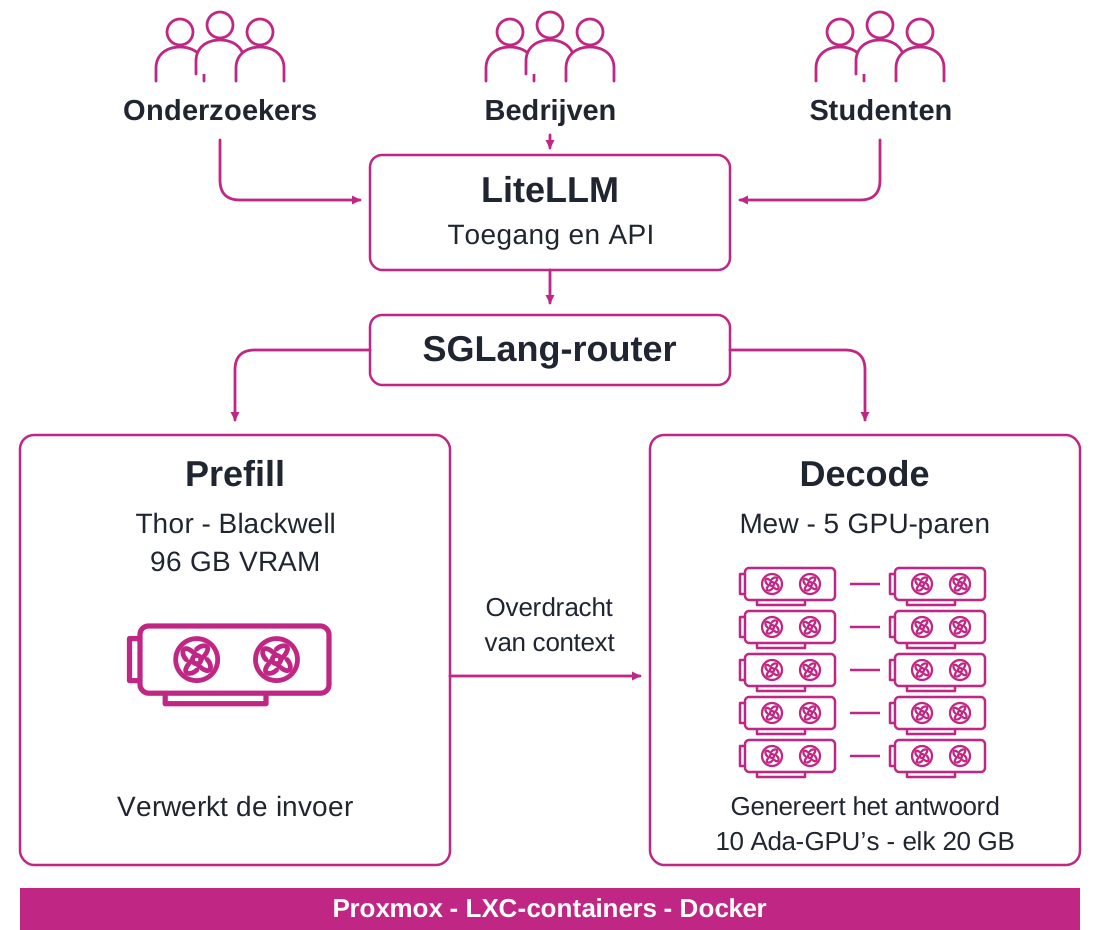
Eén AI-dienst voor de gebruiker, meerdere servers die het werk verdelen. LiteLLM ontvangt de requests. De SGLang-router kiest de workers. De verwerkte modelcontext gaat van prefill naar het gekozen decodepaar.
Goed. Maar wat doet die collega dan de hele dag?
Qwen helpt ons onder meer bij softwareontwikkeling, het verkennen van data en serverbeheer. Daarvoor gebruiken we graag de Pi Coding Harness, een open-source framework met een uitgebreid ecosysteem van plugins. Zo passen we onze tools aan ons werk aan. We gebruiken Pi met Qwen, maar ook met onze andere AI-abonnementen.
Het blijft niet bij softwareontwikkeling. MCP (Model Context Protocol) is een standaard waarmee AI-assistenten met bestaande software kunnen samenwerken. Zo helpt Qwen ons bijvoorbeeld de projectplanning in OpenProject te overlopen of een 3D-design uit te werken in Autodesk Fusion. Steeds meer software biedt zo'n MCP-koppeling. Ook onze eigen tools en interne informatiebronnen kunnen we op die manier toegankelijk maken voor onze AI-collega.
Ook verschillende bacheloropleidingen binnen VIVES Technologie gebruiken de cluster. In de AI Operations-cursus bouwen studenten bijvoorbeeld een multiplayergame met AI-ondersteuning. Daarna voegen ze zelf een AI-chat en andere slimme functies toe. Dezelfde AI waarmee je software bouwt, wordt zo ook onderdeel van wat je bouwt.
Er wordt al stevig gebabbeld
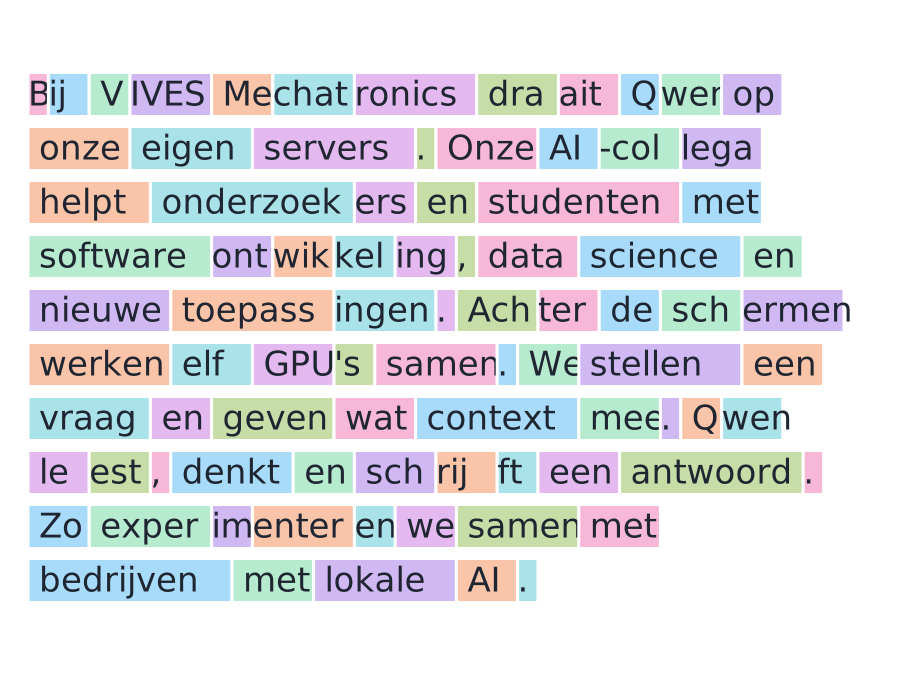
Sinds het begin van het semester draait Qwen volop mee. Op 20 oktober registreerden we:
- 80.533 geslaagde modelrequests
- 4,12 miljard verwerkte inputtokens
- 93,8 miljoen gegenereerde outputtokens
Een token is een stukje tekst, bijvoorbeeld een kort woord, een deel van een langer woord of een leesteken. Inputtokens zijn wat Qwen te lezen krijgt, zoals onze vragen, documenten en code. Outputtokens vormen de antwoorden die Qwen terugschrijft.
Om dat gebruik in perspectief te plaatsen: in LiteLLM hanteren we referentietarieven op basis van de OpenRouter-marktprijzen voor Qwen3.8-27B. Met $0,15 per miljoen inputtokens en $2 per miljoen outputtokens registreert LiteLLM voor september en oktober $826.03 aan API-gebruik.
Voor ons zit de meerwaarde vooral in de vrijheid om ermee te werken. Collega's en studenten kunnen Qwen inschakelen zonder individueel tokenbudget. We delen de capaciteit van onze eigen cluster, zodat er ruimte is om te leren, te experimenteren en onderzoeksprojecten uit te werken.
Veel tegelijk is mooi. Eindeloos wachten wat minder
Hoe snel werkt onze nieuwe collega? We testten de cluster met korte programmeervragen en antwoorden van 1.024 tokens, telkens in twee meetrondes. Bij één actieve request halen we gemiddeld 40 outputtokens per seconde. Bij twintig gelijktijdige requests liep dat op tot 571 outputtokens per seconde voor de hele cluster.
Ter vergelijking: gebruikersmetingen geven voor GPT-6.1 Sol in Codex een responssnelheid van ongeveer 40 tokens per seconde per sessie. Zowel die metingen als onze benchmark tellen de wachttijd op het eerste token mee. Bij één actieve request zit onze cluster dus in dezelfde snelheidsorde. Het tempo verschilt uiteraard per model en taak.
Veertig requests tegelijk leverden nauwelijks extra throughput op. De wachttijd tot het eerste token liep wel flink op. Bij twintig requests was 95% van de antwoorden binnen ongeveer 3 seconden op gang. Bij veertig requests werd dat 39 seconden. De kleinere GPU's waren volop aan het schrijven. Meer werk aanbieden betekent dan vooral langer aanschuiven.
Ook de vraag zelf maakt verschil. Een grote nieuwe prompt lezen vraagt meer voorbereiding dan een korte vraag beantwoorden. Met Prometheus en Grafana volgen we daarom naast snelheid ook GPU-gebruik, queues en fouten. Een hoog snelheidsgetal is leuk. Een bruikbare assistent is het doel.
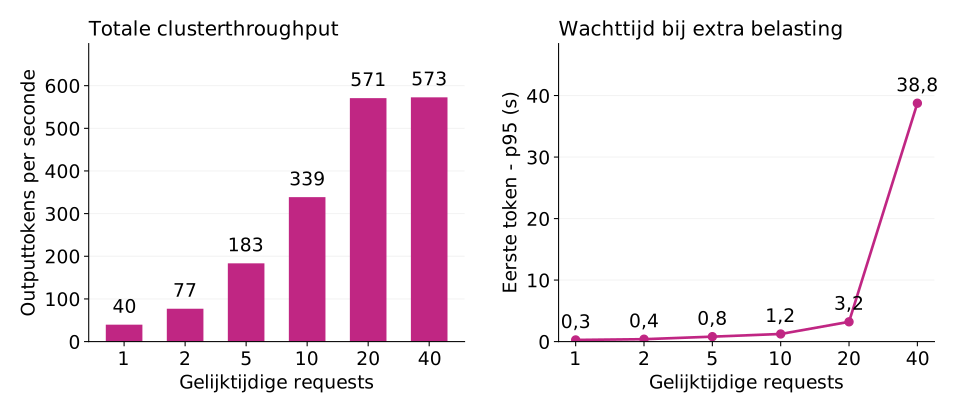
Korte programmeervragen met 1.024 outputtokens per request, twee meetrondes per belasting. De staafjes tonen de gemiddelde totale throughput van de twee meetrondes. Rechts zie je binnen hoeveel seconden 95% van de antwoorden op gang kwam.
Zin om kennis te maken met Qwen?
Misschien zie je al een taak voor Qwen in jouw bedrijf. Meehelpen aan een nieuwe applicatie, kennis opzoeken in documentatie, of gewoon eens samen een dataset uitpluizen? Neem contact op met Alexander D'hoore van Hogeschool VIVES voor een demo, toegang voor een verkennende proef, een gezamenlijk prototype of hulp bij implementatie.
Met ons projectvoorstel Local LLM 4 Hardware willen we die mogelijkheden verder verkennen met bedrijven die elektronica en embedded systemen ontwikkelen of testen. Denk aan firmware development, PCB-verificatie of het analyseren van meet- en testdata. Ook buiten dat voorstel staan we open voor samenwerking.
Wij hebben de servers al warmgedraaid! Wat wil jij proberen?
Bronnen
- Hugging Face - NVIDIA Qwen3.8-27B-NVFP4
- LiteLLM - Open-Source AI Gateway & LLM Proxy
- SGLang Documentation - Qwen3.8-27B
- Pi - A Minimal Agent Harness
- MCP - What Is the Model Context Protocol?
- OpenProject - MCP Server Documentation
- Autodesk Fusion - Introducing the Fusion MCP
- AI Operations - VIVES Elektronica-ICT
- OpenRouter - Qwen3.8 27B Pricing & Benchmarks
- Tokrate - Codex Model Speed in Tokens per Second
Met steun van VLAIO
Een deel van deze serverhardware werd aangekocht via het OI.HS-onderzoeksinfrastructuurproject Versatile Edge Cluster.